AIに調査を頼み、その返事が来るまで画面を見て待つ。別のAIにも同じことを頼み、今度はそちらを待つ。並列実行の仕組みがあっても、親の作業が止まるなら、人の待ち時間はあまり減りません。
OpenCodeは2026年11月13日、v2.3.0を公開しました。今回の中心は、サブエージェントが標準でバックグラウンド実行になったことです。依頼直後に親セッションへ制御が戻り、子の処理中も別の作業を続けられます。
変わったのは「待ち方」
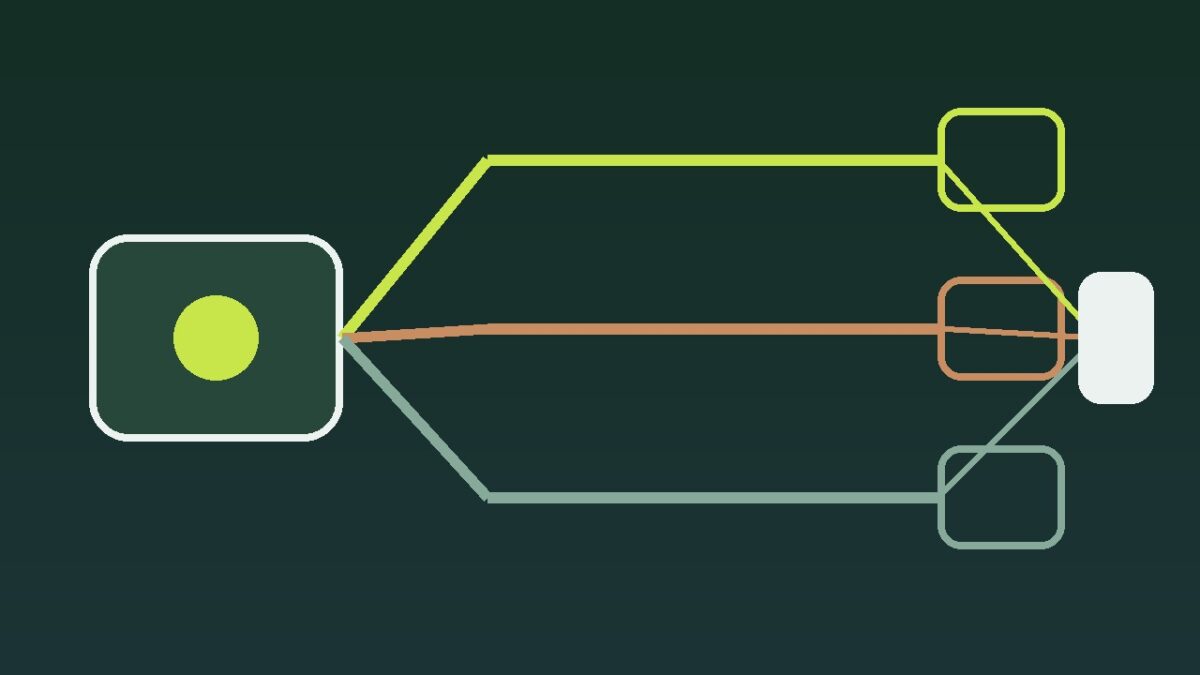
公式リリースと実装Pull Requestによると、サブエージェントの起動はセッションIDをすぐ返し、処理は裏で継続します。子が待機状態になると、結果が親へ報告されます。親は子の終了をその場で待たず、次の指示や別の調査へ進めます。
子エージェント自身がさらにバックグラウンド処理を抱えている場合も補正されました。途中の待機を完了と誤認せず、「まだ処理中」と親へ伝え、最終報告を待ちます。並列化より先に必要だったのは、この完了判定です。
同じ版では、ツール実行と思考のまとまりを1行へ畳む低Verbosity表示も標準になりました。詳細は設定で戻せます。複数の作業を同時に走らせても、親セッションがログで埋まりにくい設計です。
会社の仕事では、依頼と回収を分ける
この更新は、AIを増やす話というより、仕事の受け渡しを分ける話です。たとえば親へ「今週の営業会議資料を作る」と依頼し、競合調査、数値照合、過去議事録の確認を子へ分ける。親は待たずに構成を作り、結果が返った順に差し込みます。
ただし、バックグラウンド化すると人の目から処理が離れます。速さだけを見て採用すると、失敗した子、古い前提で動く子、同じ対象を重複して調べる子が残ります。必要なのは、誰に何を渡したか、いつ終わったか、結果をどこへ保存したかを親側で持つことです。
公式情報は実行方式と画面表示の変更を説明していますが、処理時間や費用が何%減るとは示していません。並列数を増やせば、モデル利用量と外部ツールの呼び出しも増えます。時間短縮と費用増を同じ表で測るべきです。
業務の分け方にも条件があります。相互に依存する作業を同時に渡すと、古い前提のまま別々の結論を作ります。競合3社の個別調査のように、入力と完了条件を独立させられる仕事から始めるのが安全です。最後の統合と判断は親へ残します。
バックグラウンド処理が長引いたときの扱いも先に決めます。一定時間を超えたら停止するのか、そのまま待つのか、別の子へ引き継ぐのか。タイムアウトを失敗として記録しなければ、親には「返事がない仕事」だけが積み上がります。
最初の検証は3本で十分
- 同じ親タスクから、独立した調査を3本だけ起動する。
- 各子のセッションID、開始時刻、最終報告、保存先を記録する。
- 直列実行と比べて、完了時間、失敗数、重複作業、モデル利用量を確認する。
親が次の作業を続けられ、3本すべての最終結果を回収でき、重複や取りこぼしがなければ限定GOです。途中報告を完了と誤認する、失敗が親へ戻らない、成果物の保存先が分からない。このどれかが出たらHOLD。並列数を増やす前に回収方法を直します。
私なら、最初は読み取りだけの調査に使います。対外送信、公開、削除、金銭処理はバックグラウンドの子へ直接渡しません。AIが裏で動けるほど、親の役割は指示役から回収と承認へ寄ります。仕事を投げる入口と、結果を戻す正本の保存先はセットです。